面向 AI 推理的 KV Cache 扩展加速系统

将大规模推理所需的上下文记忆从 TB 扩展至 PB 级别,释放 GPU 显存,提升 Token 生产力
Banner

吞吐跃升

Token 吞吐最高提升 57×,从 2.3K 增长至 132K
吞吐跃升

极速响应

TTFT 延迟最高降低 98%,从 54s 优化至 0.97s
极速响应

容量扩展

TB 到 PB,上下文记忆数量级扩展
容量扩展

面向 AI 推理的 KV Cache 扩展加速系统

将大规模推理所需的上下文记忆从 TB 扩展至 PB 级别,释放 GPU 显存,提升 Token 生产力
Banner

吞吐跃升

Token 吞吐最高提升 57×,从 2.3K 增长至 132K
吞吐跃升

极速响应

TTFT 延迟最高降低 98%,从 54s 优化至 0.97s
极速响应

容量扩展

TB 到 PB,上下文记忆数量级扩展
容量扩展
AI 推理正在撞上“内存墙”
企业 AI 应用正从简单聊天对话,走向 AI 编码、企业知识库问答和多轮执行的 Agent 工作流。大模型推理对基础设施的要求已经发生转变。
重复 Prefill,算力空转
传统推理架构依赖 GPU 显存和主机内存,无法承载长上下文的 KV Cache 存储需求,相同上下文被反复计算,GPU 利用率低位徘徊。
重复 Prefill,算力空转
响应慢,首 Token 延迟高
上下文从 4K 膨胀至百万级 Token,KV Cache 无法复用时,长文档问答、多轮 Agent 的 TTFT 急剧恶化,用户体验大打折扣。
响应慢,首 Token 延迟高
并发不足,成本高企
靠堆砌 HBM(L1)和 DRAM(L2)扩展上下文成本极高;传统 NAS / 对象存储延迟高、协议重,无法满足 KV Cache 对于高带宽、低时延的需求。
并发不足,成本高企
全局共享的 KV Cache 存储池,
破解推理“内存墙”
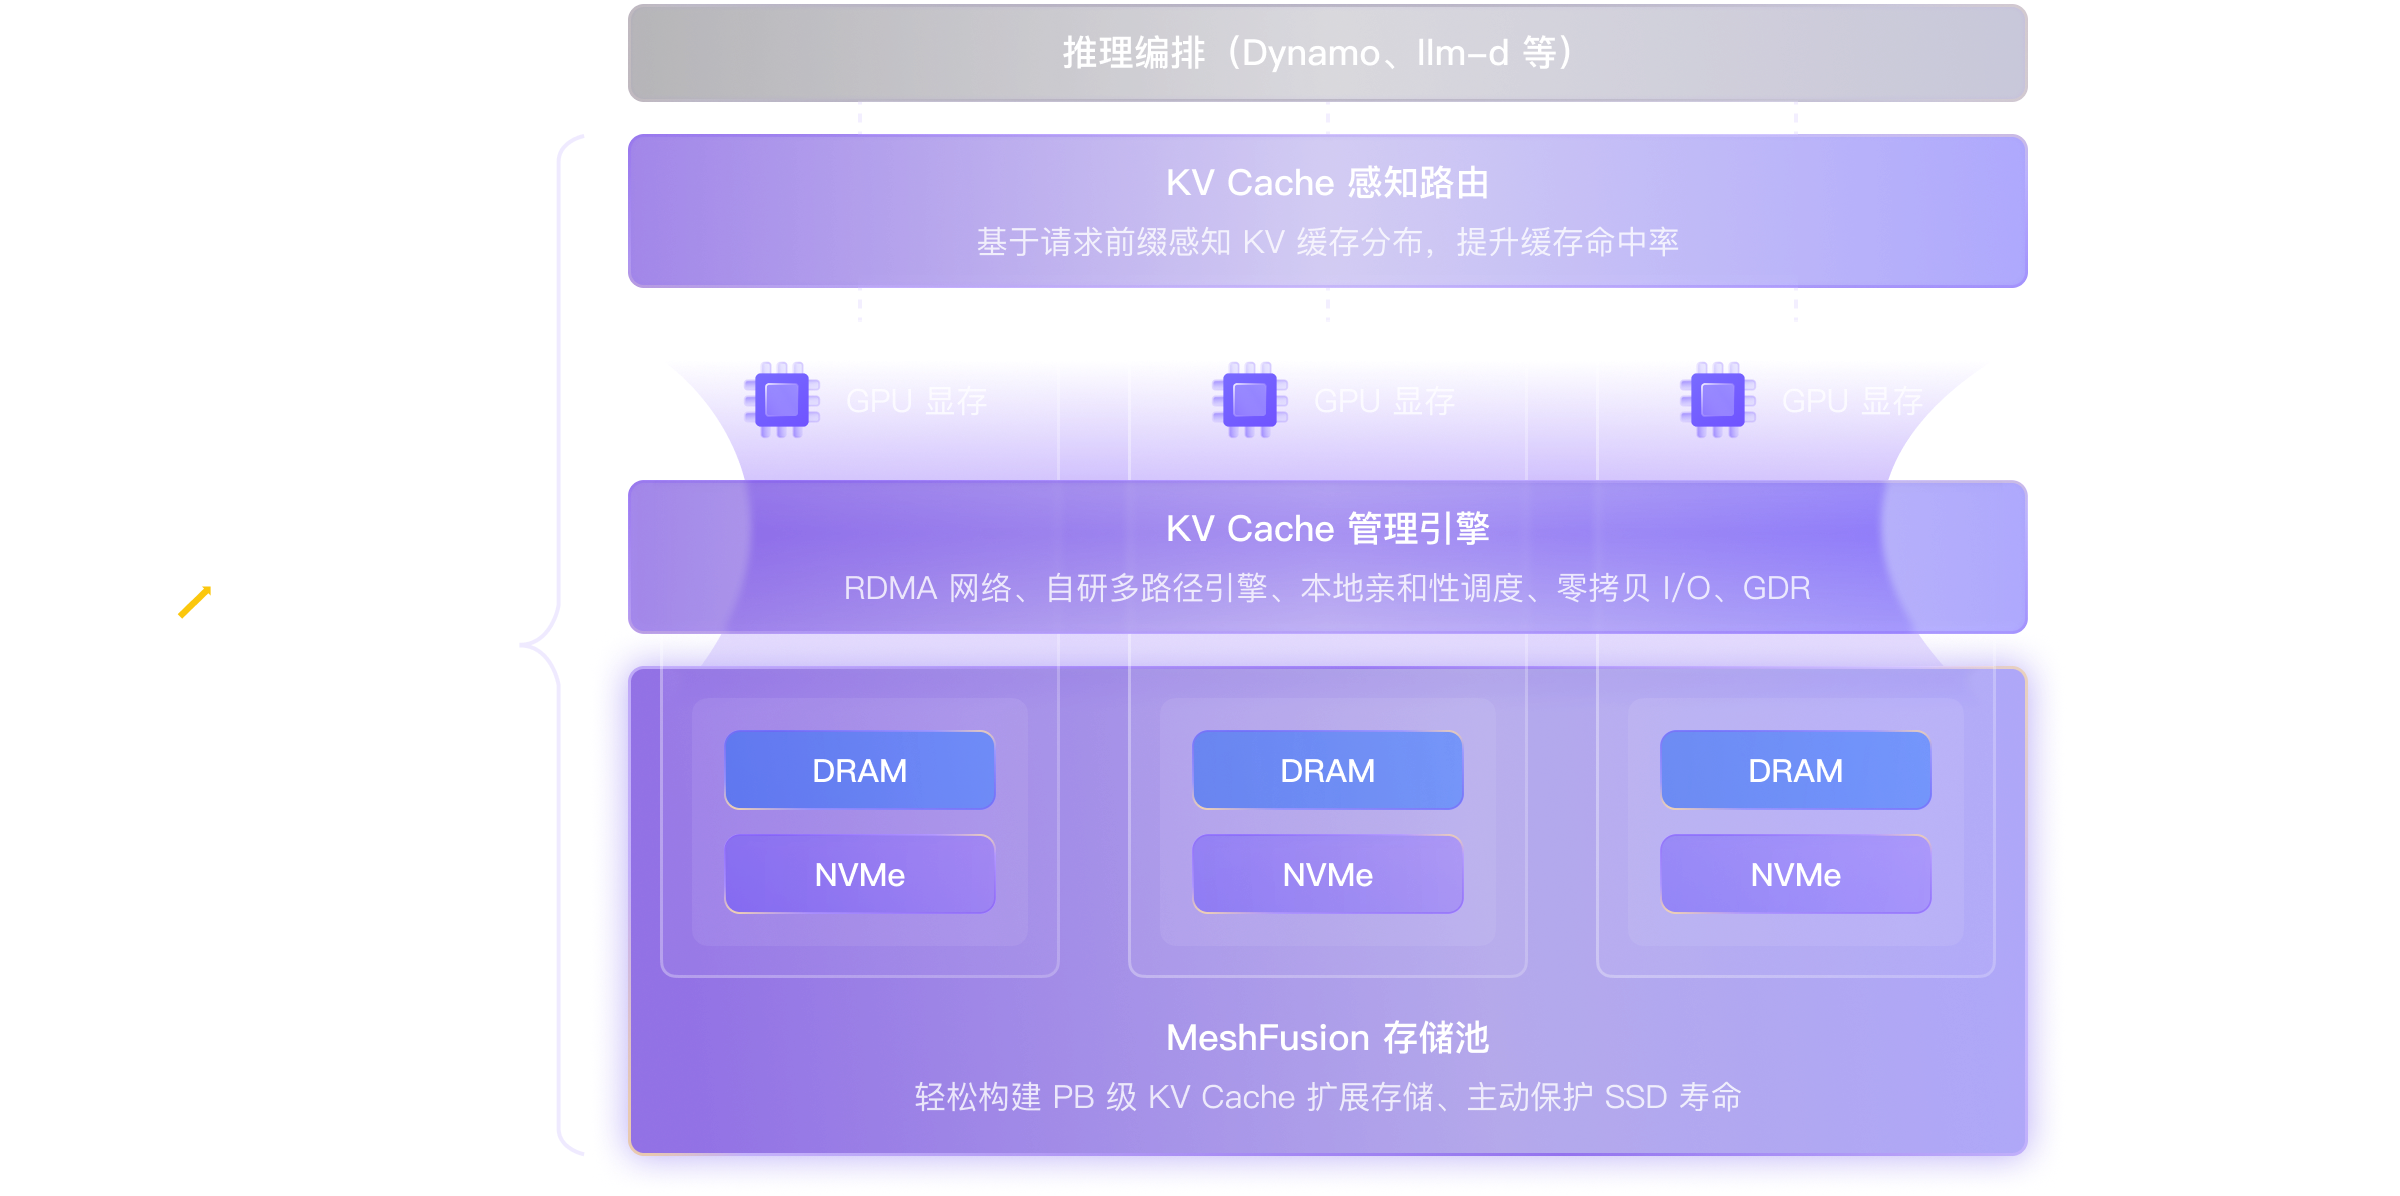
XSKY MeshFusion 星飞 AI 推理加速系统,基于端到端的 RDMA 技术将多个节点上的 DRAM 和 NVMe SSD 组织成大容量、高性能的 KV Cache 存储池,结合自研的 KV Cache 感知路由与管理引擎将 KV Cache 从稀缺的 GPU 显存扩展至 PB 级存储,有效提升推理效率、解决 AI 推理的“内存墙”问题。
权威第三方实验室实测:推理性能显著跃升
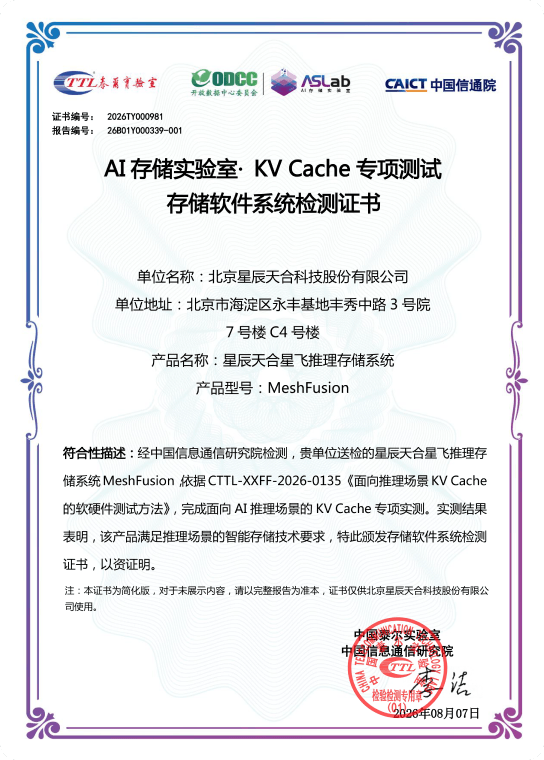
在权威第三方实验室中进行了专业检测。测试结果表明,在长上下文 AI 推理场景中,相比传统推理架构,部署 MeshFusion 能够给 LLM 推理集群带来显著提升
MeshFusion AI 存储实验室 KV Cache 专项测试存储软件系统检测证书
TPS 提升57×
从 2.3K 增长至 132K
读带宽276 GiB/s
达到集群理论带宽的 90.6%
TTFT 降低98%
从 54s 优化至 0.97s
QPM 提升6×
随缓存命中率显著提升
核心价值
激活本地 SSD,支持跨节点共享
融合部署在 GPU 服务器上,直接利用本地 NVMe 组成全局共享缓存池,实现本地低延迟与跨节点共享兼得。
激活本地 SSD,支持跨节点共享激活本地 SSD,支持跨节点共享
降低 TTFT,提升用户体验
复用历史 KV Cache,减少重复 Prefill 计算,显著缩短首 Token 等待时间,让长文档问答、多轮 Agent 工作流和 AI 编码响应更快。
降低 TTFT,提升用户体验降低 TTFT,提升用户体验
提升 Token 吞吐,释放集群生产力
通过高命中率 KV Cache 复用和高带宽存储取回能力,提升单位 GPU 可承载的并发请求与 Token 输出能力。
提升 Token 吞吐,释放集群生产力提升 Token 吞吐,释放集群生产力
降低推理成本,减少 GPU 堆叠
以 NVMe SSD 承接高价值 KV Cache,用更低成本的存储资源替代重复计算和显存扩容,提升 GPU 利用率。
降低推理成本,减少 GPU 堆叠降低推理成本,减少 GPU 堆叠
广泛的模型与算力平台兼容,无缝融入推理生态

兼容亮点

  • 支持与英伟达 GPU、华为昇腾 NPU、阿里 PPU 等 AI 推理服务器融合部署,亦可部署在创新的 DPU + JBOF 环境中;
  • 率先在国产昇腾 NPU 上支持 Kimi K3、GLM-5.2 等新一代混合注意力模型的 KV Cache 正确卸载,填补 CANN 生态的能力空白。
MeshFusion 广泛的模型与算力平台兼容

部署形态

融合部署融合部署

融合部署

利用 GPU 服务器闲置 CPU 与本地 NVMe 构建存储池,无需专用硬件,极致性价比。

分离部署分离部署

分离部署

构建独立存储集群,适合超大规模 AI 工厂,存算资源解耦扩容、统一精细化治理。

四大关键特性

原生 KV Cache 接口,用户态零拷贝 I/O

传统文件或对象协议并非为 KV Cache 设计,MeshFusion 专为 AI 推理优化:

  • 提供原生 KV Cache Chunk 语义接口,避免传统协议转换开销和冗余数据路径
  • 基于 SPDK、GDR 的零拷贝 I/O 技术,避免多余的 CPU 上下文切换与内存拷贝

本地亲和 + 全局共享,破解本地 SSD 数据孤岛

MeshFusion 采用本地亲和的 KV Cache 调度策略:

  • KV Cache 数据优先读写本地 NVMe,降低网络依赖
  • KV Cache 感知路由将请求优先调度到已缓存的节点,提升命中率
  • 当请求迁移、PD 分离、节点故障或容量不足时,支持跨节点读写

全局空间智能分配,主动保护 SSD 寿命

基于 XSKY 自研的 Shared-Everything 架构,针对 KV Cache 高频写入、淘汰的特点提供 SSD 寿命保护:

  • 全局 Chunk 分配,感知容量、磨损度和节点状态
  • Append-only 顺序追加写,降低随机写放大
  • Chunk 级整块 TRIM,减少 FTL 反复搬移

FlexPath 智能网络引擎,面向推理 I/O 优化

MeshFusion 通过 FlexPath 智能网络引擎提升 KV Cache 取回效率与网络可靠性:
  • 支持 RoCE、InfiniBand 等 100G / 200G / 400G 网络
  • 自动识别多网卡、多子网,支持多路径聚合与负载均衡
  • 协议自适应 RDMA 优先,异常时可回退 TCP

典型应用场景

AI Coding 与代码助手

长上下文代码仓库、多轮修改、复杂工具调用频繁复用历史上下文,KV Cache 命中收益明显。
企业知识库问答

知识库问答需要长文档、多轮追问和共享前缀,MeshFusion 可降低重复 Prefill,提升响应效率。
复杂 Agent 工作流

Agent 执行任务时上下文不断累积,KV Cache 复用有助于保持长记忆并降低推理成本。

MaaS / Token 工厂

在多租户、高并发、大规模推理平台中,MeshFusion 提升单位 GPU Token 产出效率。

XSKY MeshFusion 让 AI 记忆无限延伸
即刻申请,获 30 天免费使用
在线咨询
快速响应您的问题
工作日: 9:00 ~ 18:00
官方微信